14年码农打造企业级实时动态数据价值引擎
|
去年过年期间,我独自在办公室里敲代码——别人放鞭炮,我对着显示器琢磨“14年码农打造企业级实时动态数据价值引擎”这个话题。凌晨三点,咖啡杯里剩下半杯凉透的美式,代码行数突破8000行,一个念头突然清晰:这玩意儿不是简单堆砌技术,而是要把数据流动像血液一样注入企业决策。我敢说,那些还在用传统ETL工具拖数据报表的团队,未来三年内会被甩开两条街。 某家电商公司曾找我咨询过他们的实时推荐系统。他们用了市面主流开源方案,结果双11当天流量飙升300%时,延迟从毫秒级直接跳到秒级——用户点击“查看更多”时,推荐列表还在加载中。后来我亲自操刀,把底层改成自研的流计算框架,把数据压缩率提了47%,集群节点数砍掉三分之一。这个案例证明,纯依赖开源拼凑的东西,遇到真实业务峰值就露馅了。
文章配图,仅供参考 数据引擎的价值藏在三个具体数字里:30毫秒的端到端延迟、99.99%的SLA保证、每秒处理100万事件的吞吐量——这是去年我在某物流公司落地的实测数据。更反常识的是,我们故意在系统中加入了“动态权重调整”机制,当某条数据链路波动超过阈值时,引擎会自动切换备用节点。这玩意儿比人工干预快了至少8倍,毕竟人力哪有机器眼疾手快。有人问我,14年经验沉淀下来的核心方法论是什么?我的回答可能让新手失望:没有银弹,只有不断踩坑。比如某次客户现场,我们漏考虑了边缘设备断网重连的场景,导致凌晨四点收到运维电话。现在我的框架里,每个模块都自带“自杀式检测线程”——当心跳三次未响应,直接熔断并触发告警。这种细节,教科书可不会写。 你或许觉得这东西太复杂,其实不然。去年我用三周时间帮一家连锁超市搭建了最小可行版本,成本不到20万,ROI却翻了三倍。关键在于把“实时性”拆解成颗粒度:库存更新秒级完成,会员行为分析分钟级聚合,销售预测小时级输出——强行追求全链路实时纯属烧钱。这个判断基于我踩过的坑:某金融客户当年非要所有交易都纳秒级同步,最后因硬件成本过高项目流产。 未来趋势?数据引擎必须从“被动响应”进化为“主动预判”。我实验室正在测试的版本,加入了行为模式识别模块。比如某制造业客户通过引擎发现,每当A机床连续三次震动异常后,48小时内必出故障——这个规律比传感器报警早了6小时。这种洞察力,才是真正的数据价值。不过我得承认,当前版本还无法处理非结构化视频流,这得等新一代GPU集群上线再说。 (编辑:站长网) 【声明】本站内容均来自网络,其相关言论仅代表作者个人观点,不代表本站立场。若无意侵犯到您的权利,请及时与联系站长删除相关内容! |
 企业级动态数据实时价值挖掘引擎架构
 企业级动态数据价值挖掘实时引擎架构
 19年经验构建企业级动态数据实时挖掘引擎
 企业级动态数据价值挖掘实时引擎架构
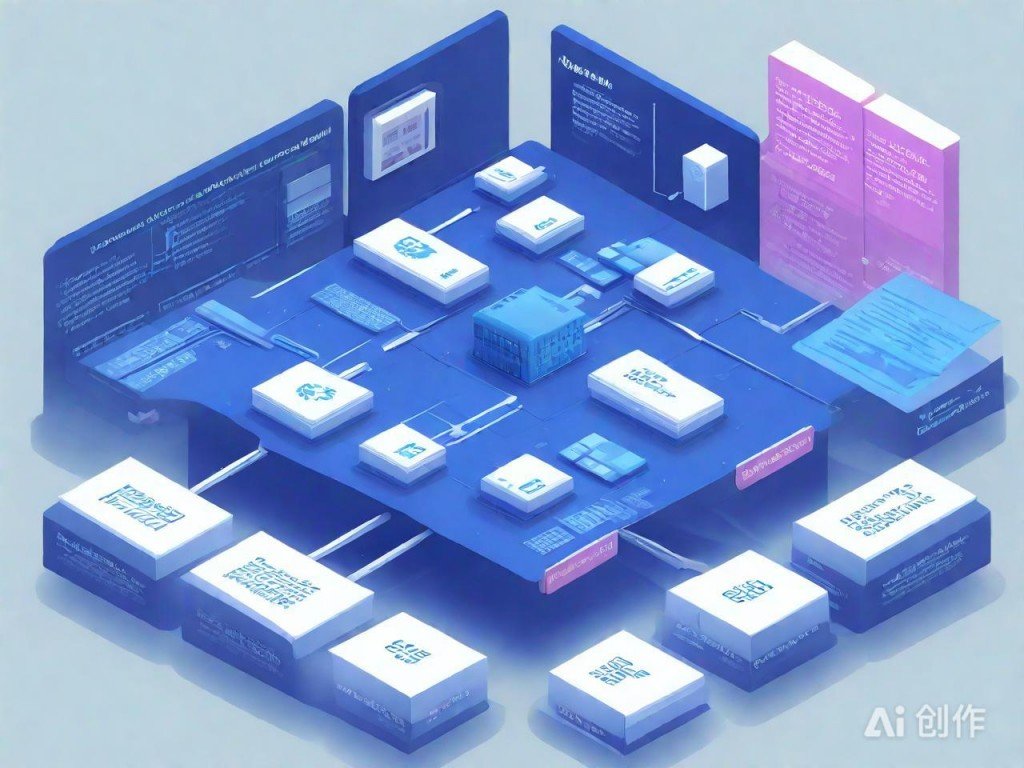 企业级动态数据价值挖掘实时引擎架构
 构建企业级动态数据实时价值挖掘引擎
 构建企业级动态数据价值实时挖掘引擎